
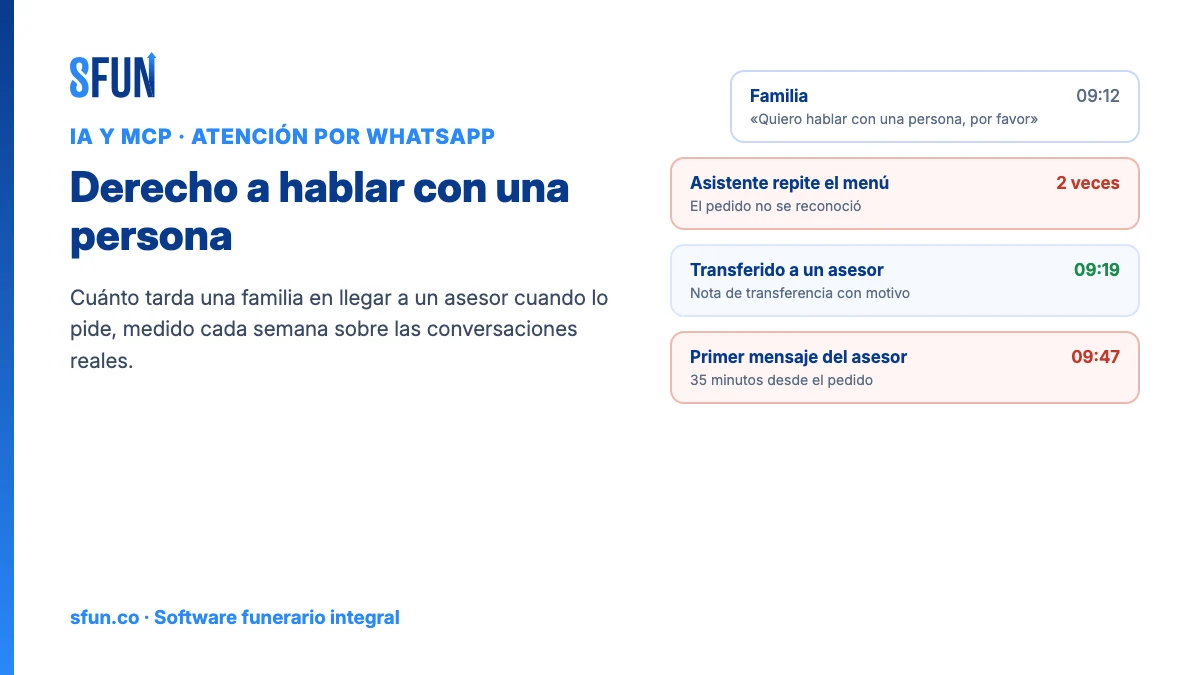
Un grupo funerario que atiende por WhatsApp con un asistente de inteligencia artificial resuelve sin intervención humana buena parte de las consultas: horarios de salas, requisitos de un traslado, estado de cuenta del plan. Pero hay un mensaje que cambia la conversación: «quiero hablar con una persona». Muchas veces lo escribe alguien que acaba de perder a un familiar, que no quiere un menú, o que ya intentó dos veces y no obtuvo respuesta.
La pregunta de la dirección es sencilla y casi nadie la puede responder con datos: cuando una familia pide hablar con una persona, ¿cuánto tarda en recibir el primer mensaje de alguien del equipo? Y la siguiente: ¿cuántas veces ese pedido no llega a nadie?
Este artículo es un caso de uso concreto de inteligencia artificial conectada al ERP por MCP, escrito para la gerencia de servicio al cliente, la jefatura del centro de contacto y la dirección comercial de un grupo funerario o de previsión. Complementa el análisis de conversaciones de WhatsApp (que mira el volumen completo) y el bucle diario de mejora del asistente: aquí se mide un solo momento, el paso del asistente a una persona, con su reloj completo.
1. El problema de negocio: el pedido que no llega a nadie
La Oficina de Protección Financiera del Consumidor de Estados Unidos (CFPB) describió el problema en su informe sobre asistentes conversacionales en la banca (junio de 2023): clientes que quedan dando vueltas en respuestas automáticas sin poder llegar a una persona. En una funeraria el costo es mayor, porque el motivo del contacto suele ser un fallecimiento, una cobertura en duda o un cobro que la familia no entiende. Hay cuatro formas típicas de fallar:
- El pedido no se reconoce. La familia escribe «necesito un asesor» y el asistente vuelve a ofrecer el menú. Detectar ese pedido depende de cómo se diseñó cada asistente, no de la plataforma.
- La transferencia ocurre, pero nadie la toma. La conversación queda en la cola de un equipo y, tras un tiempo de inactividad, se cierra sola. La familia no recibe respuesta y nadie se entera.
- La respuesta llega tarde. El asesor contesta, pero una hora después, cuando la familia ya llamó a otra funeraria.
- La respuesta llega fuera de la ventana. WhatsApp solo permite escribir libremente dentro de las 24 horas siguientes al último mensaje del cliente; pasado ese plazo, el asesor necesita una plantilla aprobada, y si no la usa, el mensaje no sale.
El estándar de mercado se está moviendo. En España, la Ley 10/2025, de 26 de diciembre, que regula los servicios de atención a la clientela, prohíbe que la atención sea exclusivamente automática y obliga a ofrecer atención por una persona física a solicitud del cliente, en cualquier momento de la interacción (art. 8). Fija además el objetivo de que el 95 % de esas solicitudes se atiendan, de media, en menos de tres minutos. Aplica a servicios básicos y a empresas grandes de ese país, no a Latinoamérica; pero describe con precisión lo que una familia espera de cualquier canal: poder llegar a una persona cuando lo pide, y pronto.
2. Qué datos del ERP intervienen
El caso usa los registros del módulo de atención por WhatsApp de SFUN (Contacto AI):
| Registro | Qué aporta | Límite que hay que conocer |
|---|---|---|
| Mensaje | Texto, dirección, hora y autor de cada mensaje: familia, asistente, asesor (con su usuario) o sistema | No marca por sí mismo que la familia pidió una persona |
| Nota de transferencia | Nota interna del sistema con el motivo y el resumen que dejó el asistente al transferir, con su hora | El motivo es texto libre; no hay un campo «transferido en» |
| Nota de toma | Nota interna «Asesor X tomó la conversación» que se escribe con el primer envío del asesor | Si un asesor toma la conversación desde la cola y no escribe, esa toma no deja hora |
| Conversación | Bandeja, equipo y asesor asignados, estado del asistente (activo, transferido) y estado de la conversación | Hay una sola conversación por contacto y canal, que se reabre con cada mensaje nuevo; guarda la hora de la última respuesta del asesor, no la de la primera |
| Bandeja, equipos y asesores | Reglas de asignación automática (rotación, carga o idioma), disponibilidad y tope de conversaciones por asesor | — |
| Políticas de SLA y horario de atención | Configuración del objetivo de primera respuesta y del horario de cada bandeja | El SLA de primera respuesta se cuenta desde el inicio de la conversación, no desde la transferencia; el horario y el mensaje fuera de horario existen como configuración, pero hoy no se aplican de forma automática |
Todos esos registros se pueden leer por SFUN MCP con los permisos del usuario que consulta. Las acciones de transferir, responder y reasignar están deshabilitadas en el conector, y el modo de solo lectura bloquea cualquier otra escritura: el asistente de IA de este caso solo lee.
3. Cómo se arma con MCP, paso a paso
Lo usa la jefatura del centro de contacto o de calidad, con un asistente de IA conectado por MCP a una cuenta de solo lectura. La frecuencia es semanal, sobre las conversaciones de los últimos siete días, y por evento cuando llega una queja de «nadie me contestó».
Paso 0. Escribir qué cuenta como «pedir una persona»
Antes de medir, el equipo define la lista de expresiones que cuentan como pedido: «quiero hablar con alguien», «con un asesor», «una persona real», «llámenme», «no quiero hablar con un robot», y sus variantes con errores de escritura. También define lo que no cuenta (por ejemplo, «¿tienen asesores en otra ciudad?»). Esa lista es la regla con la que el asistente de IA clasifica, y se revisa cada mes con los casos dudosos.
Paso 1. Encontrar los pedidos de la semana
El asistente lista las conversaciones con actividad en la semana y lee los mensajes escritos por la familia, de 50 en 50, porque esa es la página del conector. Marca cada mensaje que coincide con la regla del paso 0 y guarda su hora. La hora que importa es la del mensaje del pedido, no la del inicio de la conversación: como cada contacto tiene una sola conversación que se reabre, la fecha de inicio puede ser de hace meses.
Paso 2. Reconstruir el reloj de cada pedido
Para cada pedido, el asistente busca hacia adelante en la misma conversación tres marcas:
| Marca | Dónde se lee | Tramo que cierra |
|---|---|---|
| Transferencia | Primera nota interna de transferencia después del pedido | Pedido → transferencia: ¿el asistente reconoció el pedido? |
| Primer mensaje humano | Primer mensaje con autor «asesor» después de la transferencia | Transferencia → primera respuesta: ¿el equipo respondió a tiempo? |
| Cierre | Estado final de la conversación | Si se cerró sin mensaje humano, el pedido se perdió |
El tiempo total es el que vive la familia: del pedido al primer mensaje de una persona. El cálculo lo hace el asistente conversación por conversación; el conector no resta fechas en sus agregados, y por eso este caso trabaja sobre una semana y no sobre un año completo.
Paso 3. Clasificar el desenlace de cada pedido
| Desenlace | Cómo se reconoce | Dueño de la corrección |
|---|---|---|
| Atendido a tiempo | Hubo transferencia y primer mensaje humano dentro del objetivo que fijó la empresa | — |
| Atendido tarde | Hubo respuesta humana, pero fuera del objetivo | Jefatura del centro de contacto (turnos y cargas) |
| No reconocido | La familia pidió una persona y no hubo transferencia en los mensajes siguientes | Quien diseña el asistente: se convierte en caso de prueba |
| Transferido sin respuesta | Hubo transferencia y la conversación se cerró sin mensaje humano | Jefatura del centro de contacto: es el desenlace más grave |
| Fuera de horario | El pedido llegó cuando el equipo no atendía | Dirección: decidir cobertura o un aviso honesto a la familia |
| Ventana vencida | El asesor respondió después de 24 horas y necesitó plantilla, o no pudo escribir | Jefatura del centro de contacto |
El entregable: una ficha semanal de una página
- Número de pedidos de la semana y su reparto por desenlace.
- Mediana y percentil 90 del tiempo del pedido al primer mensaje humano (el promedio esconde los casos que más duelen).
- Los mismos tiempos por bandeja, equipo y franja horaria.
- La lista de pedidos «transferidos sin respuesta» y «no reconocidos», con enlace a cada conversación, para que una persona los revise y decida si se contacta a la familia.
4. El bucle de mejora continua
- Cada pedido «no reconocido» se agrega al banco de conversaciones con el que se prueba la siguiente versión del asistente antes de publicarla (ver simular conversaciones antes de publicar). La meta es que la misma frase no vuelva a fallar.
- Cada pedido «transferido sin respuesta» se revisa el mismo lunes: ¿a qué equipo fue?, ¿había asesores conectados?, ¿la asignación automática estaba activa? Si la familia sigue sin respuesta, una persona decide si se le escribe con plantilla.
- Cada semana, la ficha se compara con la anterior por franja horaria. Si la noche y el fin de semana concentran los tiempos largos, la conversación es de turnos, no de tecnología.
- Cada mes, se revisa la lista de expresiones del paso 0 con los casos dudosos y se ajusta.
5. Gobierno y límites
- Solo lectura. La cuenta del asistente de IA no transfiere, no responde, no asigna ni cierra conversaciones. SFUN MCP tiene un modo de solo lectura para toda la instalación que bloquea cualquier escritura; actívalo para este caso.
- Nunca escribe a la familia. Si un pedido quedó sin respuesta, decide una persona si se retoma y con qué mensaje; recontactar a una familia en duelo exige criterio.
- Datos del doliente. Las conversaciones contienen datos personales y, a veces, la causa del fallecimiento. La ficha lleva la hora, el desenlace y el enlace a la conversación, no el texto completo; el acceso queda limitado a quien gestiona la calidad del canal.
- No es un ranking de asesores. El tiempo de respuesta depende de turnos, cargas y reglas de asignación. Usar la ficha para sancionar a un asesor sin mirar el turno produce el efecto contrario: respuestas rápidas y vacías.
- Revisión humana de lo dudoso. Cuando el asistente no está seguro de si un mensaje es un pedido, lo marca como dudoso y lo decide una persona.
6. KPIs: cómo saber si funcionó
| Indicador | Línea base | Meta a 90 días |
|---|---|---|
| Pedidos reconocidos (transferidos dentro de los dos mensajes siguientes) | Medir las primeras cuatro semanas | Más del 95 % |
| Pedidos transferidos que se cerraron sin mensaje humano | Medir las primeras cuatro semanas | Cero |
| Mediana del pedido al primer mensaje humano, en horario de atención | Medir las primeras cuatro semanas | La que fije la empresa; como referencia de mercado, minutos y no horas |
| Percentil 90 del mismo tiempo | Medir las primeras cuatro semanas | Bajar a la mitad |
| Pedidos fuera de horario que recibieron un aviso claro de cuándo se atenderán | Medir las primeras cuatro semanas | 100 % |
7. Hoja de ruta de adopción
- Semana 1. Escribir la lista de expresiones del paso 0, crear la cuenta de solo lectura para el asistente de IA y fijar el objetivo de tiempo por franja (en horario y fuera de horario).
- Mes 1. Correr la ficha cada lunes, sacar la línea base y revisar uno por uno los pedidos transferidos sin respuesta. Revisar si cada asistente publicado sabe transferir cuando se lo piden.
- Trimestre 1. Ajustar turnos y reglas de asignación con los datos por franja, llevar los pedidos no reconocidos al banco de pruebas y decidir qué responde el canal fuera de horario.
Errores comunes
- Medir desde el inicio de la conversación y no desde el pedido: en una conversación reabierta, el inicio puede ser de hace meses.
- Usar el promedio de primera respuesta del panel, que mide la última respuesta del asesor.
- Contar solo las conversaciones transferidas: los pedidos no reconocidos nunca llegan a la cola y son justamente los que más importan.
- Mirar el promedio y no el percentil 90.
- Revisar la ficha sin decidir qué pasa con las familias que quedaron sin respuesta.
Lo que otros sectores ya hacen
En banca, el informe de la CFPB convirtió los bucles sin salida en un tema de supervisión: un asistente que no reconoce que el cliente quiere a una persona es un riesgo de cumplimiento, no solo de experiencia. En los servicios básicos y las empresas grandes de España, la Ley 10/2025 pasó el derecho a ser atendido por una persona a la ley, con un objetivo medible de tiempo. La traducción al sector funerario es directa: lo que en una aseguradora o una eléctrica es el tiempo hasta un operador humano, en una funeraria es el tiempo que espera una familia en duelo que pidió hablar con alguien. La diferencia es que en una funeraria no hay ley que lo exija; hay algo más inmediato, que es la familia eligiendo a otro proveedor esa misma noche.
Qué existe hoy en SFUN y qué es hoja de ruta
| Pieza | Estado |
|---|---|
| Transferencia del asistente a una persona con motivo y resumen en una nota interna con hora; pausa del asistente | Existe |
| Asignación automática por rotación, carga o idioma, y cola de equipo para que un asesor tome la conversación | Existe |
| Hora y autor de cada mensaje (familia, asistente, asesor o sistema) | Existe |
| Control de la ventana de 24 horas de WhatsApp y reapertura con plantilla aprobada | Existe |
| Lectura por MCP de conversaciones y mensajes, con los permisos del usuario | Existe (hasta 50 filas por página) |
| Modo solo lectura del servidor MCP | Existe, para toda la instalación |
| Detección del pedido «quiero hablar con una persona» | Depende del diseño de cada asistente; no es una función de la plataforma |
| Ficha semanal del pedido a la primera respuesta humana | La arma el asistente de IA con sus instrucciones; no es un informe del ERP |
| Campos de hora de transferencia y de primera respuesta humana | Hoja de ruta |
| SLA medido desde la transferencia y aplicación automática del horario de atención | Hoja de ruta |
| Alerta cuando una transferencia se cierra sin que nadie la tome | Hoja de ruta |
Preguntas frecuentes
¿Un asistente de IA en WhatsApp puede pasar la conversación a una persona?
Sí. En SFUN, el asistente transfiere la conversación al equipo con un motivo y un resumen, se pausa y la conversación queda en la bandeja para un asesor. Que el asistente reconozca cuándo la familia lo pide depende de cómo se haya diseñado.
¿Cómo se mide cuánto tarda una familia en llegar a un asesor?
Desde el mensaje en que la familia pide una persona hasta el primer mensaje de un asesor en esa conversación. Con IA y MCP, un asistente en solo lectura reconstruye ese tiempo conversación por conversación cada semana.
¿Existe una ley que obligue a ofrecer atención humana en Latinoamérica?
No con carácter general para funerarias. En España, la Ley 10/2025 lo exige a servicios básicos y empresas grandes; en Latinoamérica rigen las normas de protección al consumidor de cada país. Es una buena referencia de lo que esperan las familias.
¿Qué pasa si la familia escribe fuera del horario de atención?
Lo decide la empresa: cubrir la franja o avisar con claridad cuándo responderá una persona. Hoy SFUN guarda el horario como configuración, pero el aviso automático fuera de horario es hoja de ruta; la ficha semanal muestra cuántos pedidos llegan en esas horas.
¿El asistente de IA contesta a las familias que quedaron sin respuesta?
No. Las encuentra y las lista; una persona decide si se les escribe y con qué mensaje.
En resumen
La calidad de un asistente de WhatsApp no se mide solo por lo que resuelve, sino por lo rápido que entrega la conversación a una persona cuando la familia lo pide. En SFUN, la transferencia, la hora de cada mensaje y su autor ya quedan registrados; con IA y MCP en solo lectura se convierten en una ficha semanal que muestra cuánto espera cada familia, en qué franja y dónde se pierde el pedido. La decisión de cómo cubrir los turnos y qué decirle a cada familia sigue siendo de una persona. Si quieres verlo sobre tus propias conversaciones, conoce Contacto AI, SFUN MCP y el marco de gobierno de agentes de IA en el ERP funerario.
Fuentes
- Ley 10/2025, de 26 de diciembre, por la que se regulan los servicios de atención a la clientela (BOE), arts. 2, 8 y 10; consultada el 6 de noviembre de 2026.
- CFPB, Chatbots in consumer finance (6 de junio de 2023).
- Verificación del producto sobre el código de SFUN (módulo Contacto AI y conector MCP), 6 de noviembre de 2026.